PROJECT 08 · 旗舰 · 已完成(单任务复现)
AutoBio × π0:VLA 基础模型的 LoRA 微调复现
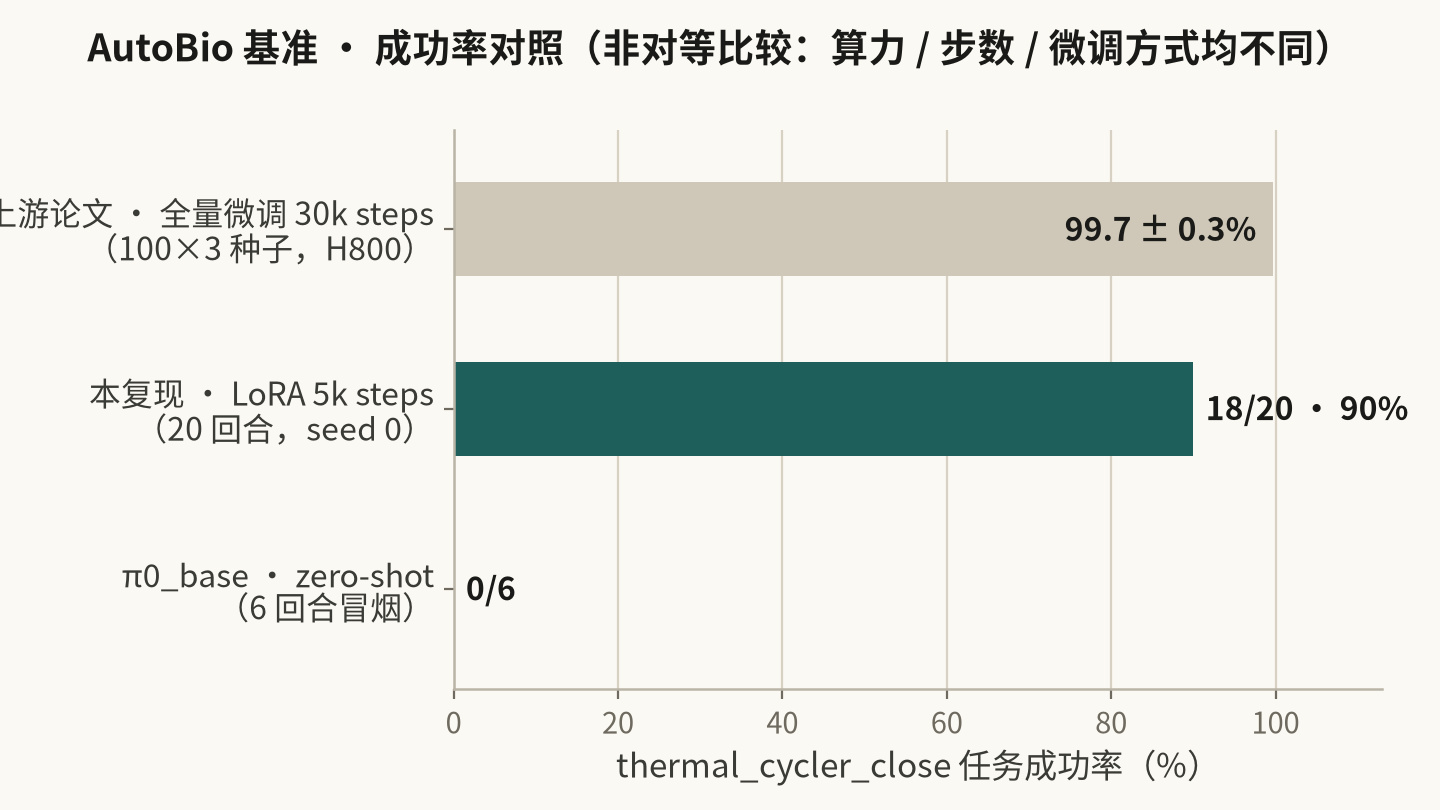
在 AutoBio(面向数字生物实验室的机器人操作仿真基准)上,对 VLA 基础模型 π0(PaliGemma 2B + 300M 动作专家)做 LoRA 微调: 先修复上游冻结快照里的几处损坏,再用单张消费级显卡训练约 7.5 小时, 把 thermal_cycler_close(合上 PCR 仪盖)任务从 zero-shot 的 0/6 提升到 18/20(90%)。权重、逐回合结果、训练曲线和 rollout 视频全部公开,可复现。
90%评测成功率 · 18/20
7.5h单卡训练时长 · 5000 步
22.2GB峰值显存 / 24GB
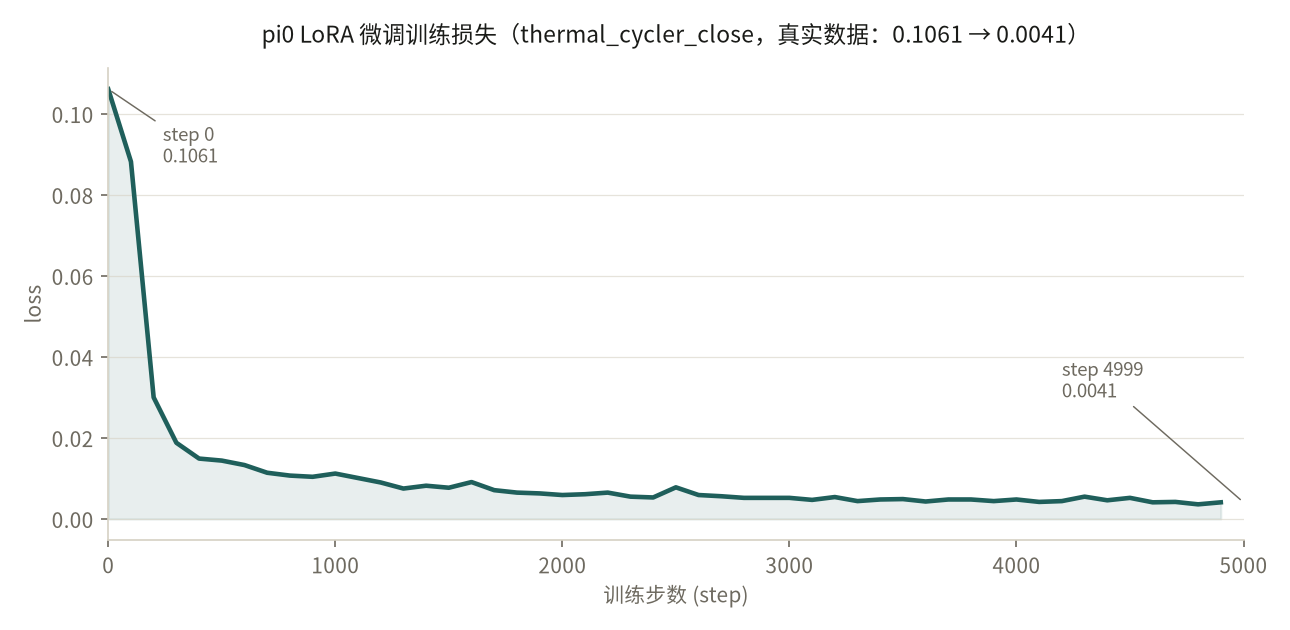
0.0041最终训练 loss(自 0.1061)
逐回合评测结果(seed 0,共 20 回合)
每一格是一次真实 rollout,来自评测脚本保存的原始 JSON,没有任何挑选。
■ 成功 □ 失败
诚实标注这次结果的边界:这是 12 个任务里最容易的一个(single task); 单种子、20 回合的置信区间较宽(Wilson 95% 约 68%–98%); zero-shot 的 0/6 只是 6 回合冒烟测试,不是严格估计; 与上游论文的全量微调(30k 步、H800 集群)在算力、步数、微调方式上都不对等。 它证明的是「我能在真实 VLA 代码栈上完整地跑通数据→训练→评测并修好途中的工程问题」, 而不是一个可外推的 SOTA 数字。
复现途中修的上游问题(fork 改动)
autobio/task.py— 修复 6 处过期的任务导入路径,让全部 12 个任务能再次 import;openpi/scripts/train.py— 补上wrap()里缺失的return,修复非 SLURM 机器上训练结束时的KeyError: SLURM_JOB_ID;openpi/uv.lock— 锁定nvidia-cuda-nvcc-cu12==12.9.86,RTX 5090(sm_120)必需;- 新增
export_lora.py/load_lora.py(可移植的 LoRA 权重导出/合并)与独立推理 demo。
训练配置(全部真实记录)
# 单卡 RTX 5090 D v2 (24GB) · WSL2 Ubuntu 24.04 · 2026-10
XLA_FLAGS="--xla_gpu_enable_triton_gemm=false" \
uv run scripts/train.py thermal_cycler_close-lora \
--exp-name lora5k --batch-size 16 --save-interval 1000
# 基座 pi0_base;LoRA:主干 rank=16/alpha=16,动作专家 rank=32/alpha=32
# 数据:thermal_cycler_close-mujoco(100 episodes,LeRobot v2.0)
# 5000 步 · ~5.3 s/step · ~7.5 h · 峰值显存 22.2 GB
公开产物
完整复现笔记 约 2800 字长文:环境改造、上游修复、同种子对照、11 条踩坑实录 约 12 分钟 →
GitHub 仓库(复现 fork)
HuggingFace · 完整权重 4.9GB
LoRA delta 100MB · Release
rollout 视频(4 成功 + 4 失败对照)
上游论文 arXiv:2505.14030
AutoBio 基准(仿真资产、任务、数据集与论文)的全部功劳属于上游 AutoBio 团队;本仓库只是其上的复现学习与修复。
这段经历给我的
- 第一次完整走通 VLA 基础模型的微调闭环:LeRobot 数据 → norm stats → LoRA 训练 → checkpoint 服务 → MuJoCo EGL 无头评测。
- 学会在真实科研代码上排障:过期导入、SLURM 假设、新架构(sm_120)的 CUDA/JAX 兼容,一个个啃下来。
- 理解了 LoRA 的取舍:用 1/200 的训练预算换来接近的可感效果,代价是泛化与上限。
下一步
用同样流程做更难的任务(拧盖、移液)与多种子评测,把置信区间收窄;再尝试 RDT 基座的对比。更远的目标是把「微调 VLA 基座」变成自己工具箱里的常规操作,接到自己的仿真项目上。
PythonJAXopenpiπ0LoRAMuJoCo EGLLeRobot v2.0WSL2