PROJECT 03 · 进行中
强化学习从零实现(DQN → PPO → MuJoCo)
为了真正弄懂强化学习,我从零实现过两个算法,并让它们一步步走向真实物理:先用 Double-DQN 学会离散控制(CartPole,从随机策略训练到稳定把杆平衡),再用 PPO 挑战连续控制(Pendulum 倒立摆),最后把同一份手写 PPO 直接搬到 MuJoCo 物理仿真的 InvertedPendulum 上,验证它能迁移到真实刚体动力学。 环境和算法都自己写了一遍,不借助现成的 RL 库。
可交互 CartPole — 先你来,再让 AI 来
存活步数:0
↑ 先点"我来玩",用 ← → 方向键稳住杆——我给你放宽到 ±30° 都很难撑久;再点"让 AI 来玩",跑的是我训练的 DQN,用严格的 ±12°(benchmark 原值)也能撑满 500 步。这就是"人觉得难 → 算法解决它"的对比。AI 在浏览器里实时推理,权重本地加载、不联网。
真实训练曲线 · Double-DQN 从零解决 CartPole
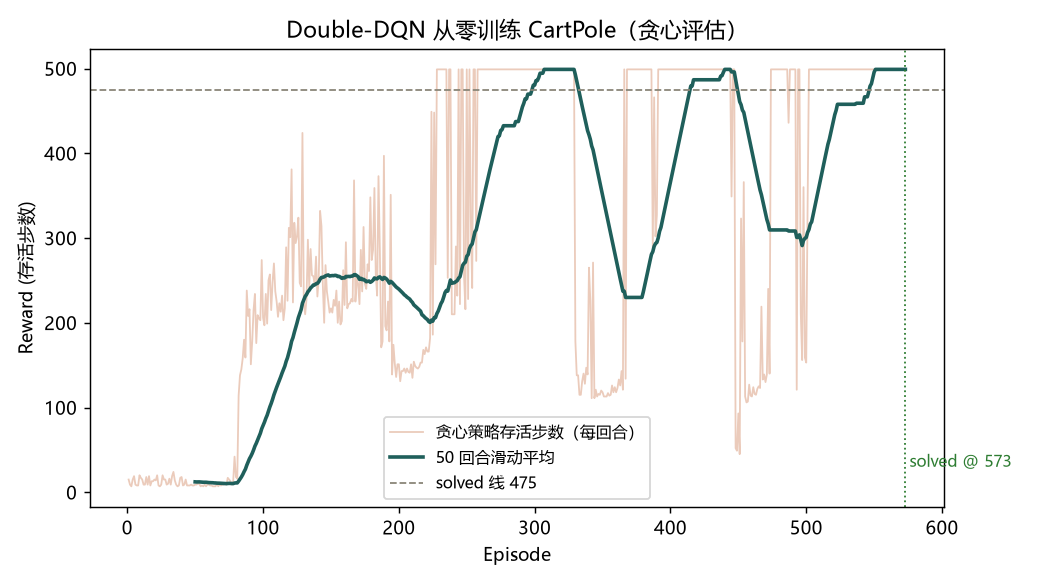
↑ 真实产出(非示意):贪心策略存活步数 + 50 回合滑动平均,第 573 回合越过 solved 线 475。曲线里的震荡正是 DQN 的真实脾气——靠 Double-DQN + 软更新目标网络才压稳。
真实训练曲线 · PPO 从零训练 Pendulum(连续控制)
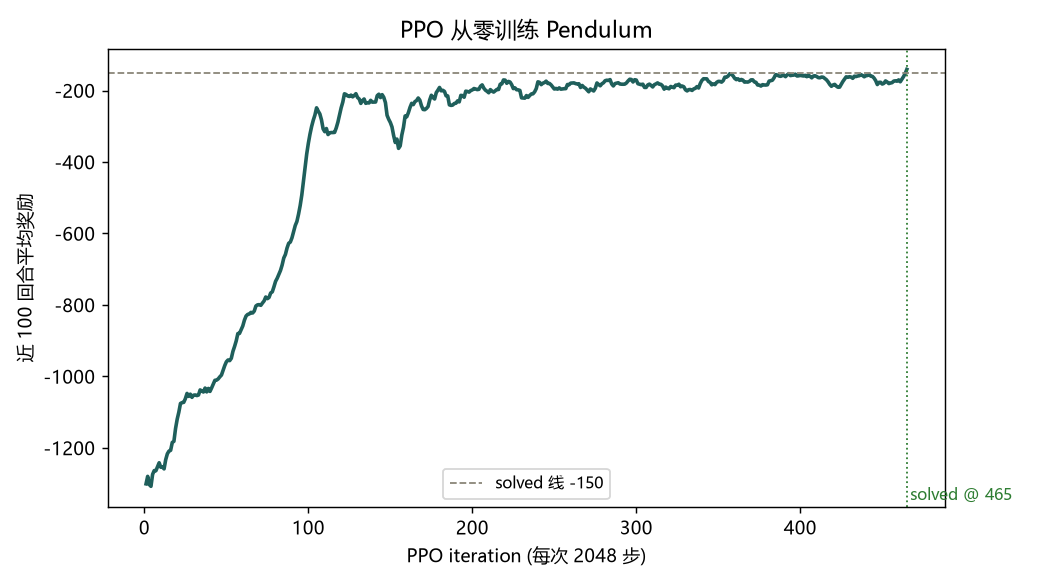
↑ 真实产出:近 100 回合平均奖励从 ~-1300 一路提升,在第 465 个 iteration 越过 solved 线(-150),最佳单回合接近满分(稳定摆到顶点并平衡)。PPO 是 on-policy、面向连续动作的算法,和 DQN 是两条路子。
真实训练曲线 · 同一份 PPO 迁移到 MuJoCo 物理(InvertedPendulum)
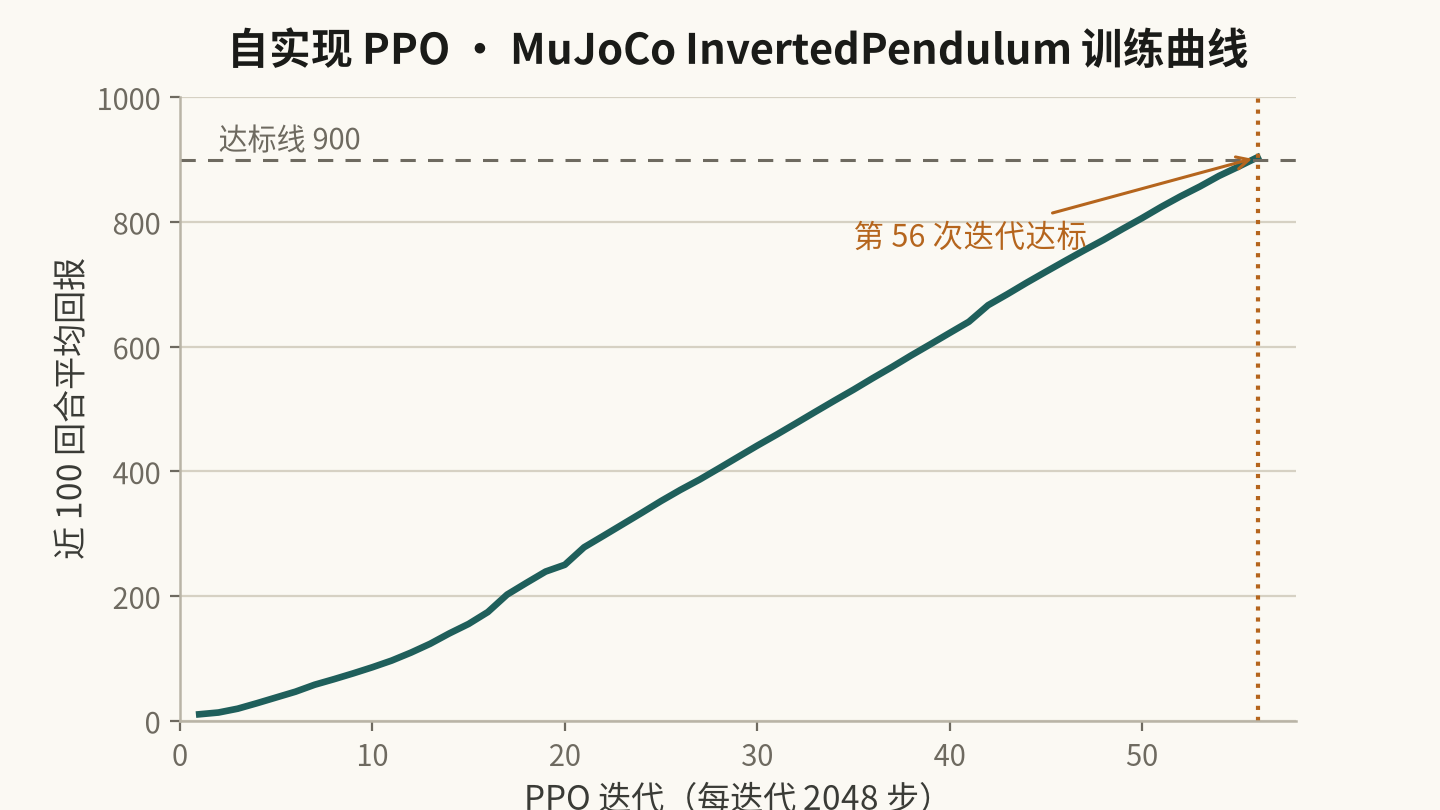
↑ 没改一行 PPO 算法代码,只把环境从 classic-control 换成 MuJoCo 刚体动力学,第 56 个 iteration 就把近 100 回合平均回报练到 903(满分 1000);用确定性策略复测 20 局全部 1000。这一步是从"玩具环境"跨到"真实物理仿真",也是把策略迁移到真机前的必经环节。
为什么从零写
现成的 RL 库很方便,但我想真正理解 DQN 的每一步,所以环境和算法都自己实现了一遍。 过程中体会到不少坑:Q 值高估、目标网络漂移、探索与利用的平衡、学会又忘记—— 这些光看别人的代码不容易懂,亲手调一遍才明白。
比如最初的朴素 DQN 训练曲线反复震荡(冲到 400 又崩回 200),后来用了 Double-DQN、软更新目标网络,并用贪心策略判定是否解决,曲线才稳定越过 475。 比起结果,这段调试过程让我收获更大。
目前进度:CartPole(离散,DQN)、Pendulum(连续,PPO)都已跑通,同一份 PPO 也已迁移到 MuJoCo 物理的 InvertedPendulum;下一步想挑战更复杂的 MuJoCo 任务(如 Reacher / Hopper)。
技术栈
PyTorchNumPyDouble-DQNPPOGAEActor-CriticReplay BufferMuJoCo
代码结构(已实现)
# dqn-cartpole/ (离散控制:DQN)
envs/cartpole.py # 手写 CartPole 环境(Gym 标准动力学)
dqn.py # Q 网络 + Replay Buffer + Double-DQN + 软更新
train.py # 训练循环 + 贪心评估判 solved + 出图
# ppo-pendulum/ (连续控制:PPO)
ppo.py # 独立 Actor/Critic + 裁剪目标 + 优势归一化
train_ppo.py # rollout + GAE + lr 衰减,训练 Pendulum
train_mujoco.py # 同一份 PPO 迁移到 MuJoCo InvertedPendulum
完整代码与训练脚本已整理成一个独立小项目,需要的话欢迎联系我。